Data Tidak Normal di SPSS? Ini 5 Penyebab dan Cara Menghadapinya
Daftar isi
Kamu menjalankan uji normalitas, lalu hasilnya keluar: Sig. 0,003. Lebih kecil dari 0,05. Artinya data (lebih tepatnya, residual) tidak berdistribusi normal.
Tenang dulu. Ini salah satu masalah paling umum di Bab 4, dan hampir selalu ada jalan keluarnya. Langkah pertama adalah memahami penyebabnya.
Pertama: yang diuji itu residual, bukan data mentah
Untuk regresi linear, asumsi normalitas berlaku pada residual, bukan pada masing-masing variabel. Banyak mahasiswa menguji normalitas tiap variabel satu per satu, mendapati hasilnya tidak normal, lalu panik. Padahal yang semestinya diuji adalah Unstandardized Residual dari model regresi.
Di SPSS, residual bisa disimpan lewat Analyze → Regression → Linear → Save → centang Unstandardized (Residuals). Setelah itu, uji normalitas dilakukan pada variabel RES_1 yang muncul.
5 penyebab yang paling sering
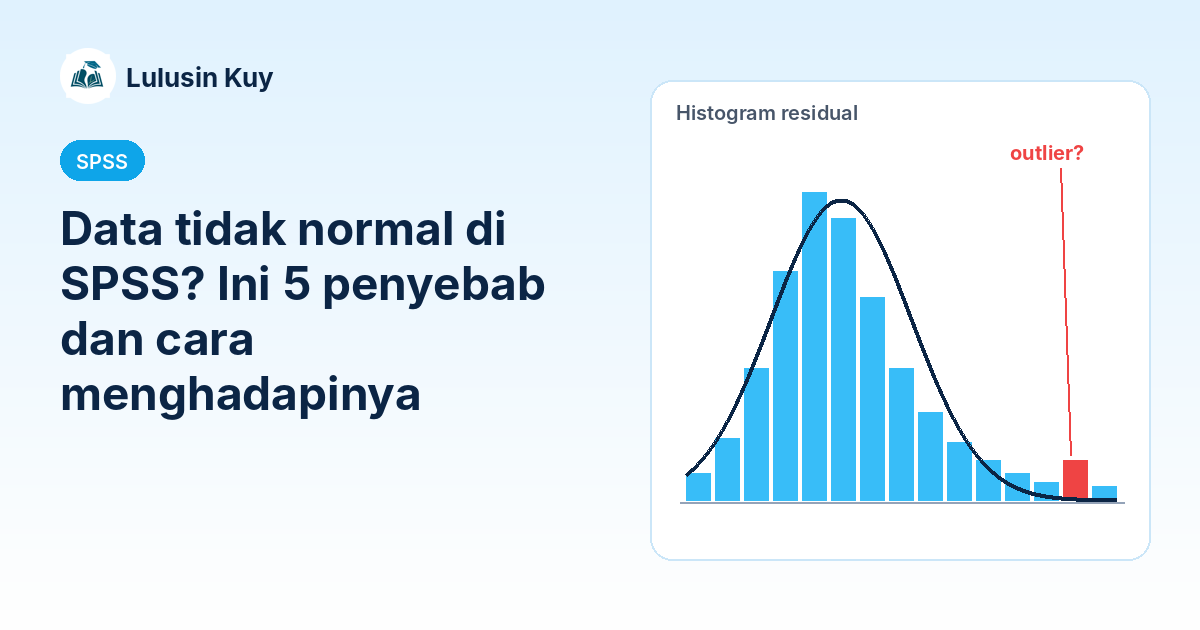
1. Ada outlier (data ekstrem)
Satu atau beberapa responden menjawab sangat berbeda dari yang lain, misalnya semua item diisi 1 sementara mayoritas mengisi 4–5. Data seperti ini menarik residual jauh ke ekor distribusi.
Cara menghadapi: deteksi dengan nilai Z-score (|Z| > 3) atau jarak Mahalanobis. Cek dulu apakah itu salah input. Kalau memang jawaban asli, kamu bisa mempertimbangkan untuk mengeluarkannya dengan alasan yang dilaporkan di Bab 4, bukan dihapus diam-diam.
2. Salah input atau coding
Angka 44 yang seharusnya 4, item unfavorable yang lupa dibalik skornya, atau sel kosong yang terbaca 0. Kesalahan kecil ini bisa merusak distribusi.
Cara menghadapi: jalankan Descriptive Statistics → Frequencies untuk melihat nilai minimum dan maksimum. Kalau skala Likert 1–5 tapi ada nilai 0 atau 44, berarti ada salah input.
3. Sampel terlalu kecil
Dengan sampel kecil (misalnya di bawah 30), satu data aneh saja sudah berpengaruh besar ke hasil uji normalitas.
Cara menghadapi: kalau memungkinkan, tambah responden. Kalau tidak, gunakan uji yang lebih sesuai untuk sampel kecil (Shapiro-Wilk) dan dukung dengan grafik Normal P-P Plot.
4. Sampel sangat besar
Kebalikannya, dengan sampel besar (ratusan responden) uji Kolmogorov-Smirnov menjadi sangat sensitif. Penyimpangan kecil yang tidak berarti pun bisa membuat Sig. < 0,05.
Cara menghadapi: lihat juga nilai skewness dan kurtosis serta grafik histogram. Banyak rujukan menyebut bahwa dengan sampel besar, regresi relatif tahan terhadap penyimpangan normalitas yang ringan (teorema limit pusat). Sertakan rujukannya di pembahasan.
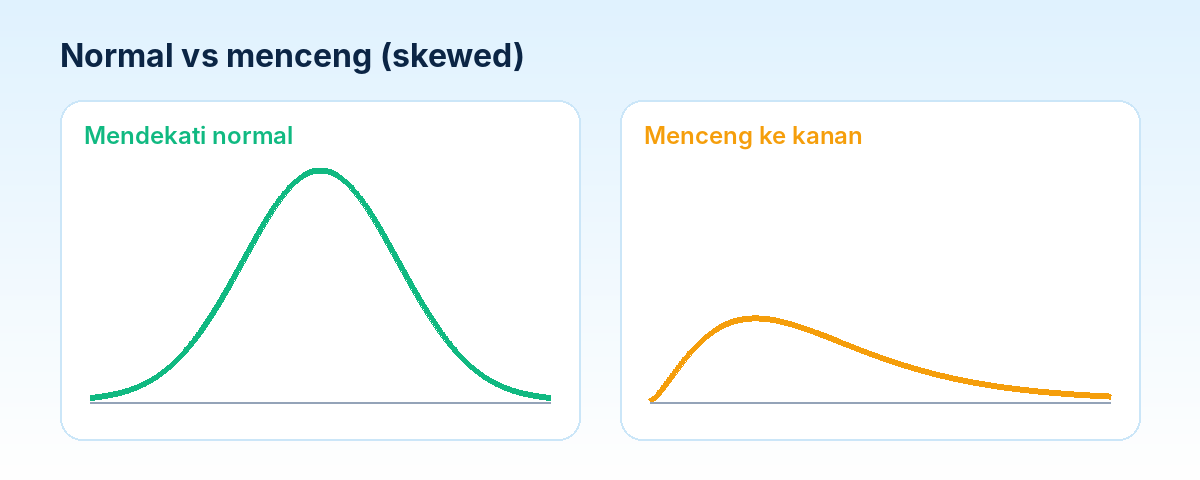
5. Distribusi data memang menceng
Beberapa jenis data secara alami tidak simetris, misalnya data keuangan (ukuran perusahaan, total aset) atau data penjualan.
Cara menghadapi: transformasi data, misalnya logaritma natural (Ln) untuk data yang menceng ke kanan. Transformasi harus konsisten dan dijelaskan di Bab 3 atau Bab 4.
Yang sebaiknya tidak dilakukan
- Mengubah jawaban responden supaya normal. Ini manipulasi data dan berisiko besar saat sidang maupun setelah lulus.
- Menghapus data sampai normal tanpa alasan. Kalau diminta menunjukkan data awal, kamu akan kesulitan menjelaskan.
- Mengganti uji tanpa memahami bedanya. Pindah ke uji nonparametrik boleh, tetapi kamu perlu tahu konsekuensinya terhadap rumusan hipotesis.
Urutan langkah yang aman
- Pastikan yang diuji adalah residual.
- Cek salah input lewat nilai minimum dan maksimum.
- Deteksi outlier dan putuskan dengan alasan yang jelas.
- Lihat ukuran sampel, lalu pilih uji dan grafik pendukung yang sesuai.
- Kalau masih tidak normal, pertimbangkan transformasi atau metode alternatif, dan laporkan secara jujur.
Kalau kamu ingin tahu kondisi datamu sebelum masuk uji hipotesis, coba Cek Kesehatan Data gratis di website ini. Kamu tinggal upload file datamu, dan dalam sekitar dua menit akan keluar rapor yang menunjukkan bagian mana yang aman dan mana yang perlu dicek ulang.